benchmark
آزمون یا مجموعهای از آزمونها برای سنجش و مقایسهٔ عملکرد نرمافزار، model یا سیستم در شرایط مشخص است.
توضیح
در benchmark، کاری مشخص با ورودی و شرایط معلوم اجرا میشود و معیارهایی مثل زمان اجرا، مصرف حافظه یا accuracy اندازهگیری میشوند. با اجرای همین آزمون میتوان چند ابزار یا نسخههای مختلف یک نرمافزار را مقایسه کرد. برای مقایسهٔ منصفانه، شرایط اجرا باید تا جای ممکن یکسان باشد و تکرار آزمون به شناخت نوسان نتایج کمک میکند. نتیجه به کار انتخابشده و شرایط اجرا وابسته است و لزوماً به همهٔ کاربردها تعمیم پیدا نمیکند.
مثال
from timeit import timeit

# زمان کل دو روش با تعداد تکرار یکسان
print(timeit("sum(range(1000))", number=1000))
print(timeit("sum(list(range(1000)))", number=1000))
چرا مهم است
وقتی بین چند ابزار انتخاب میکنی یا میخواهی اثر یک تغییر را بسنجی، benchmark به تصمیمگیری بر پایهٔ اندازهگیری کمک میکند. انتخاب کاری نزدیک به استفادهٔ واقعی مهم است تا نتیجه گمراهکننده نباشد.
مفهومهای مرتبط
این کارت را هوش مصنوعی نوشته و دو بار با هوش مصنوعی بررسی شده است.
مطالبی با این مفهوم
- LongTail-SWE

LongTail-SWE؛ سنجش agentهای کدنویسی با ۲۰۲ مسئله در ۱۳ زبان کمنماینده
benchmark جدید LongTail-SWE توانایی agentهای کدنویسی را در حل مسئلههای واقعی ۱۳ زبان میسنجد. در این ارزیابی، GLM-5.3-Flash، Qwen 3.8 27B و Qwen 3.6 27B بهترتیب Pass@1 برابر با ۴۸٫۲، ۴۲٫۷ و ۱۶٫۷ درصد داشتند.
- BotPsy

BotPsy؛ دستیار ۰٫۸ میلیاردی برای اجرای محلی کارها با ابزار
Tether AI Research مدل BotPsy را بر پایه Qwen3.5-0.8B معرفی کرد. این مدل برای function calling و کارهای agentic روی دستگاه طراحی شده و طبق آزمونهای تیم، از مدلهای آزمایششده تا ۱٫۲ میلیارد parameter پیش افتاده است.
- n8n
Gemini 4 Carbon در n8n؛ تمرکز بر امنیت و کارهای چندمرحلهای
Gemini 4 Carbon در n8n در دسترس است. این مدل بنا بر نتایج منتشرشده توسط Google، بر کارهای طولانی، امنیت و مقاومت در برابر prompt injection تمرکز دارد؛ بااینحال، همچنان به تدابیر امنیتی نیاز است.
- GPUI
GPUI؛ نقد مدل state و هزینهٔ تغییرهای کوچک در UI بزرگ
نویسنده با چند benchmark استدلال میکند که مدل state در GPUI هزینهٔ تغییرهای کوچک را به اندازهٔ ساختار UI گره میزند. او راهکارهای دقیقتر را هم نیازمند مدیریت دستی بیشتر میداند.
- Sdcb.SimdCodecs
Sdcb.SimdCodecs 1.4؛ اضافهشدن decode تصاویر HEIC با C#
نسخهٔ 1.4 پشتیبانی از decode تصاویر HEIF / HEIC را در یک package جداگانه اضافه میکند. این مجموعه کاملاً با C# نوشته شده، native dependency ندارد و با NativeAOT و WebAssembly هم اجرا میشود.
- CrowdGPT
CrowdGPT؛ تلاش جمعی برای آموزش Crowd-v1 بدون datacenter
پروژهٔ CrowdGPT میخواهد یک model با یک میلیارد parameter را بهصورت مشارکتی آموزش دهد. بهگفتهٔ سازنده، ۸۵ مشارکتکننده ثبتنام کردهاند و طی یک هفته، آموزش روی ۱۳ میلیارد token انجام شده است.
- NetWasm
NetWasm از سرعت ۲٫۸ برابری نسبت به Mono AOT در Benchmarkها خبر داد
طبق گزارش منتشرشده، NetWasm در ۲٬۲۱۳ مورد micro-benchmark به میانگین هندسی سرعت ۲٫۸ برابر Mono AOT رسیده است. اجرای DoomSharp و کاهش زمان rebuild نیز از دیگر نتایج گزارششدهاند.
- LLM Inference
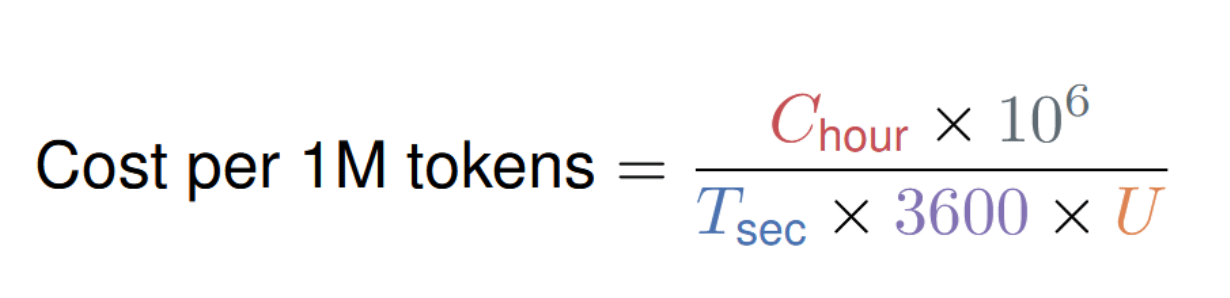
هزینه واقعی inference: چه زمانی GPU از API ارزانتر میشود؟
مقایسه DigitalOcean نشان میدهد هزینه inference فقط به قیمت GPU وابسته نیست؛ throughput، utilization و نسبت tokenهای ورودی به خروجی میتوانند نتیجه مقایسه با API را تغییر دهند.
- Postgres

تحول Postgres به سمت خودمختاری: چالشها و فرصتها
در PGConf.EU 2026، موضوع خودمختاری Postgres و چالشهای آن مورد بحث قرار گرفت. این تغییر از سیستمهای مدیریتشده به سیستمهای خودگردان در حال وقوع است.
- Python

انتشار Python 3.15؛ از unpacking در comprehension تا Tachyon و اجرای free-threaded
Python 3.15 با هشت روز تأخیر منتشر شد و قابلیتهایی مثل unpacking در comprehension و Profiler جدید Tachyon را آورد. نتیجههای اولیه نشان میدهند بهبود سرعت به نوع برنامه و شیوه اجرا وابسته است.
- AI Development
افزایش هزینه توکن در Xcode 27 MCP هنگام استفاده از Simulator
Xcode 27 MCP باعث افزایش هزینه توکن در Simulator میشود زیرا متن بیشتری نسبت به RocketSim CLI میخواند.
- uv
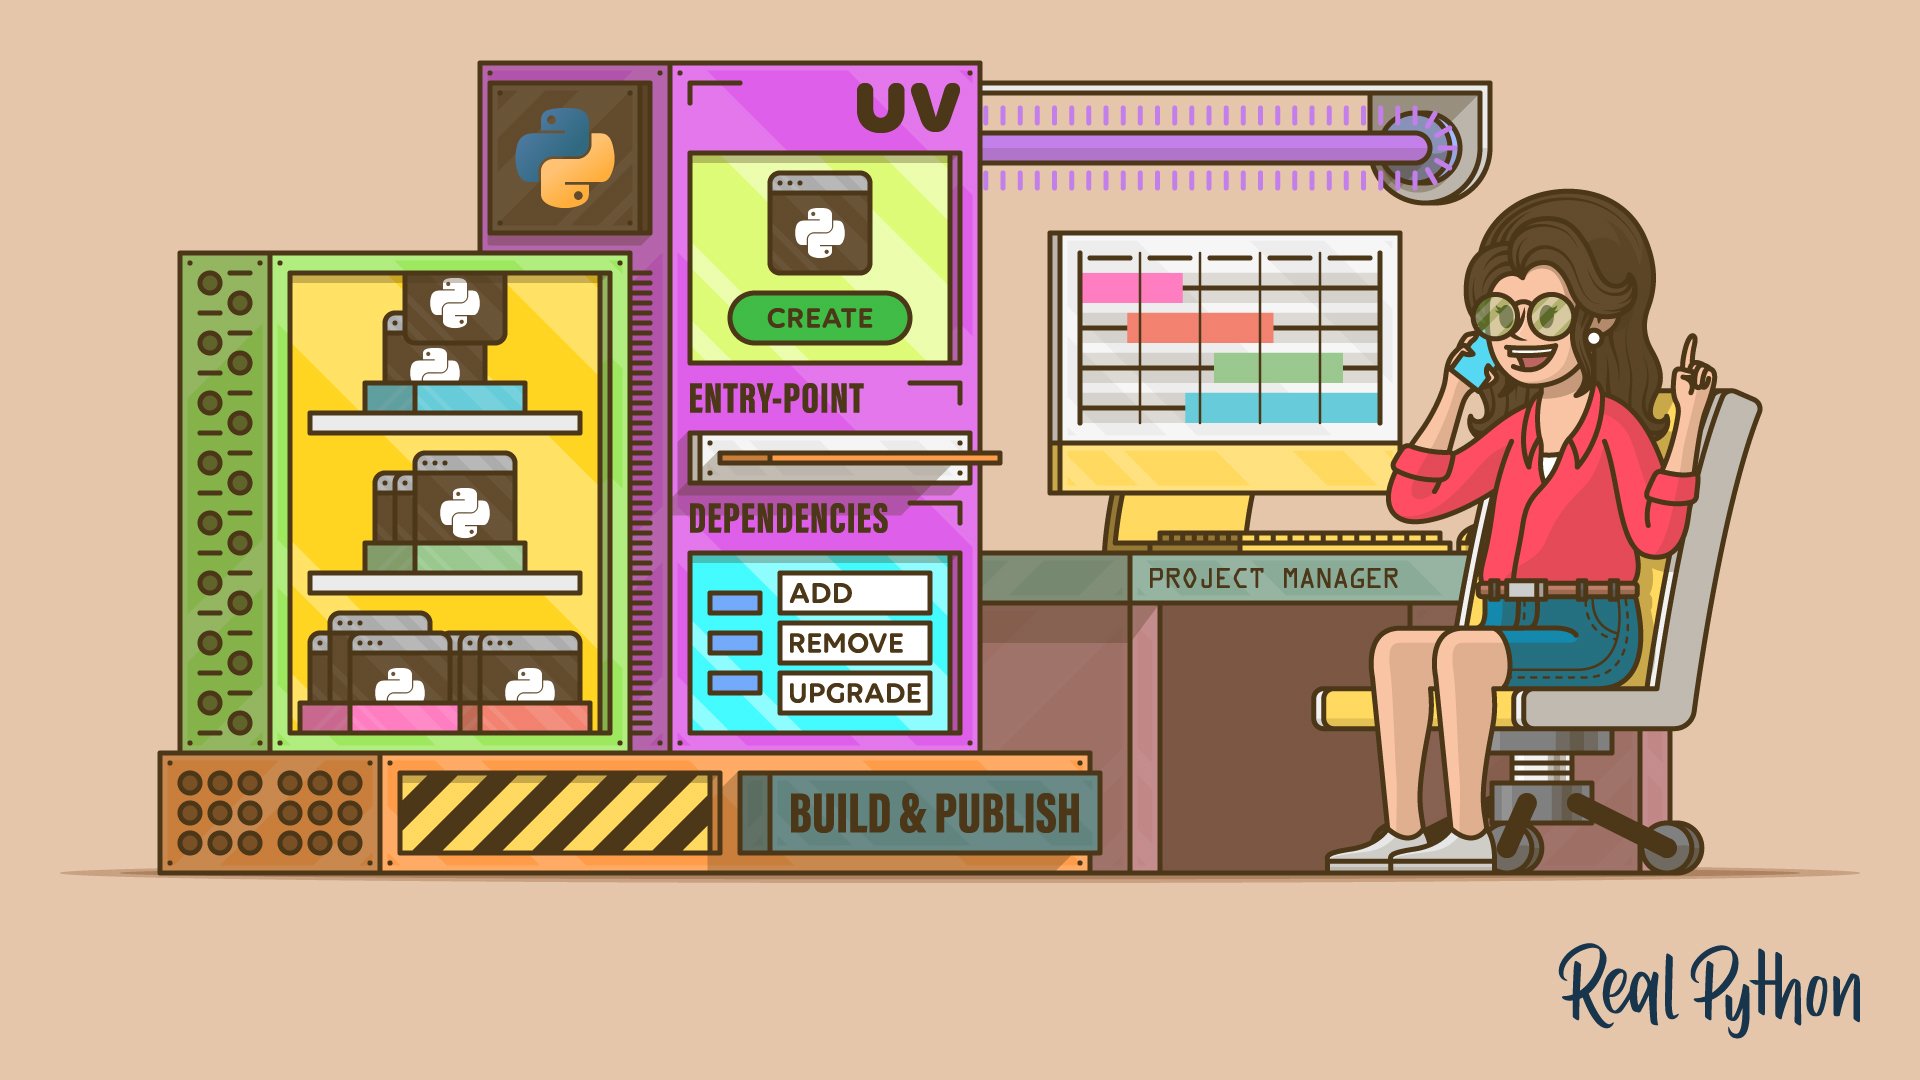
مدیریت پروژههای Python با uv؛ از dependency تا انتشار package
آموزش Real Python قابلیتهای uv را معرفی میکند؛ ابزاری نوشتهشده با Rust که نصب dependency، مدیریت نسخههای Python و virtual environment و ساخت و انتشار package را یکجا ارائه میدهد.
- AI
معرفی Kimi K3.1 Pro: مدل جدید با عملکرد بالا
Kimi K3.1 Pro به تازگی روی Kimi API عرضه شده است و انتظار میرود وزنهای کامل مدل تا ۴ نوامبر ۲۰۲۶ منتشر شود. این مدل در برخی بنچمارکها از رقبا پیشی گرفته است.