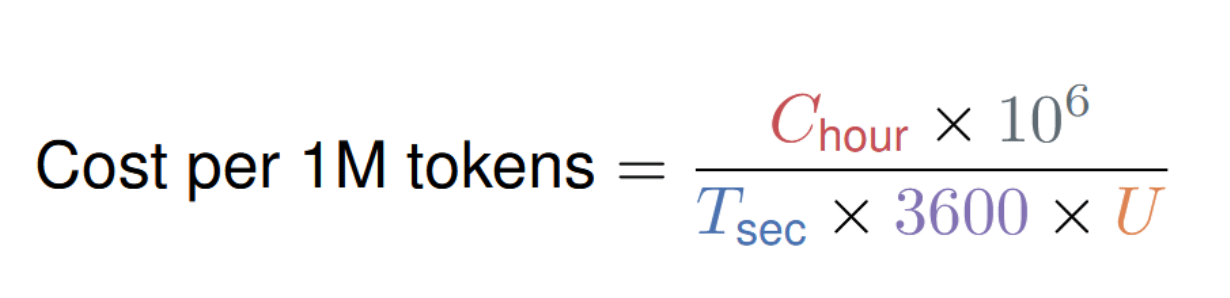
مقاله DigitalOcean هزینه inference را در دو روش استفاده از API و اجرای مدل روی GPU اجارهای مقایسه میکند. نقطه شروع این مقایسه چهار پرسش است: حجم ماهانه token چقدر است، ترافیک چقدر ثبات دارد، چه سطحی از کیفیت مدل لازم است و چند مهندس میتوانند مسئول عملیات باشند؟ API هزینه را متغیر میکند، اما در self-hosting حتی GPU بیکار هم هزینه دارد.
برای محاسبه هزینه self-hosting بهازای یک میلیون token، باید هزینه ساعتی را بر تعداد واقعی token ارائهشده در همان ساعت تقسیم کرد. هزینه ساعتی فقط اجاره GPU نیست؛ هزینه load balancer، storage، monitoring و زمان مهندسی هم در آن قرار میگیرد. throughput مجموع خروجی برای همه کاربران همزمان است، نه سرعتی که یک کاربر میبیند. ابزارهایی مانند vLLM، SGLang و TensorRT-LLM چند درخواست را خودکار با هم پردازش میکنند.
متغیر مهم دیگر utilization است: سهم زمانی که GPU واقعاً کار مفید انجام میدهد. اگر GPU روزانه فقط شش ساعت مشغول باشد، utilization برابر ۲۵ درصد است و هزینه مؤثر هر token چهار برابر عدد حاصل از Benchmark خواهد بود.
در سمت API، نسبت ورودی به خروجی اهمیت زیادی دارد. طبق مقاله، token خروجی معمولاً چهار تا هشت برابر ورودی قیمت دارد. مقایسهها با نسبت سه token ورودی به یک token خروجی انجام شدهاند. همچنین batch inference، prompt caching و flex mode میتوانند در شرایط مطرحشده در مقاله هزینه API را کاهش دهند؛ از جمله وقتی پردازش میتواند منتظر بماند یا بخش ثابتی از prompt تکرار میشود.
نمونه عددی مقاله، اجرای gpt-oss-120b روی یک NVIDIA H100 با اجاره ساعتی ۴٫۴۱ دلار است. با throughput برابر ۶٬۳۶۰ token در ثانیه و utilization صددرصدی، هزینه GPU بهازای یک میلیون token حدود ۰٫۱۹ دلار محاسبه میشود. در حالت پاسخ سریعتر برای هر کاربر و utilization بیستدرصدی، این رقم به ۲٫۳۲ دلار میرسد. در مقابل، قیمت ترکیبی همین مدل در DigitalOcean Serverless با نسبت ورودی به خروجی یادشده ۰٫۲۵ دلار است. این اعداد جدول GPU را نباید با هزینه کامل عملیات یکسان گرفت؛ چارچوب مقاله هزینههای جانبی و زمان مهندسی را هم جزو محاسبه میداند.