throughput
مقدار کاری که یک سیستم در واحد زمان انجام میدهد؛ در inference میتواند مجموع token پردازششده در ثانیه برای همه کاربران باشد.
این تعریف را هوش مصنوعی از روی مطالب فیدآپ نوشته است.
مطالبی با این مفهوم
- LLM Inference
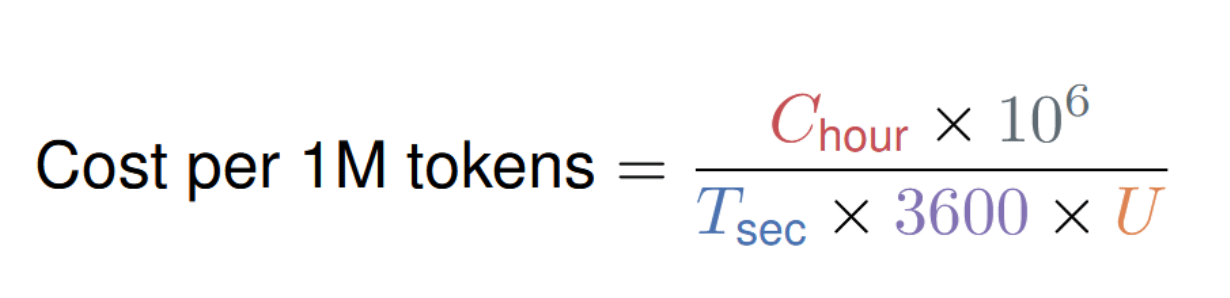
هزینه واقعی inference: اجاره GPU چه زمانی از API ارزانتر است؟
مقایسه DigitalOcean نشان میدهد هزینه inference فقط به قیمت GPU بستگی ندارد؛ میزان استفاده، سرعت پاسخ هر کاربر و نسبت token ورودی به خروجی هم تعیینکنندهاند.