Nikolay Samokhvalov در آزمایشی روی Postgres، هزینه انتخاب UUIDv4 بهعنوان primary key را با UUIDv7 و int8 مقایسه کرده است. نتیجه اصلی به اندازه index نسبت به حافظه بستگی دارد: تا وقتی index در حافظه جا میشود، تفاوت نرخ INSERT کم است؛ اما با عبور از این محدوده، هزینه کلید تصادفی آشکار میشود.
این آزمایش با Postgres 18.6، شانزده client و یک INSERT تکردیفی در هر transaction انجام شده است. سه جدول، schema و جریان INSERT یکسان داشتند و فقط primary key آنها متفاوت بود. هر جدول علاوه بر primary key، روی user_id و created_at هم index داشت؛ بنابراین حتی جدولهای دارای کلید مرتب نیز هزینه یک index با INSERT تصادفی را میپرداختند. نسبتهای اصلی عملکرد، بین کلیدها روی یک server محاسبه شدهاند.
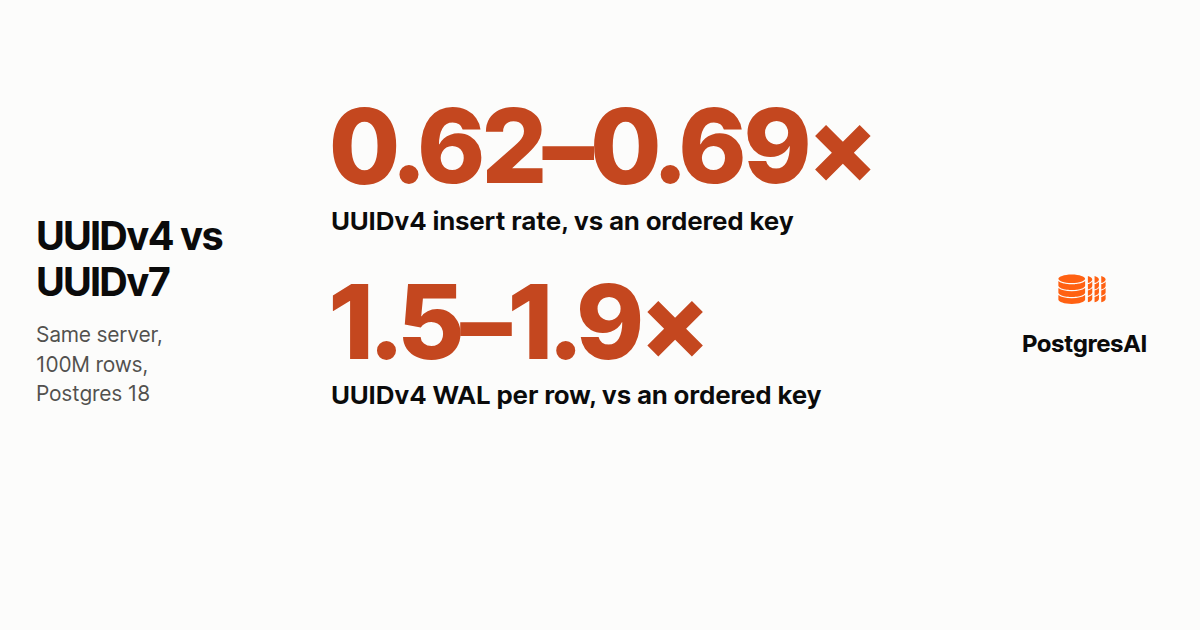
در حالتی با shared_buffers برابر ۱ GiB و سقف حافظه ۳ GiB، افت UUIDv4 از حدود ۲۶ میلیون ردیف شروع شد؛ جایی که index مربوط به primary key از shared_buffers بزرگتر شد. در ۱۰۰ میلیون ردیف، نرخ INSERT با UUIDv4 به ۶۲ تا ۶۹ درصد نرخ کلید مرتب روی همان server رسید. توضیح گزارش این است که هر INSERT با UUIDv4 به یک leaf تصادفی میرود و پس از عبور از سقف حافظه، تقریباً به یک خواندن buffer و یک نوشتن صفحه خارجشده از حافظه نیاز دارد.
هزینه write-ahead log نیز جداگانه اندازهگیری شد. در بازه ۹۰ تا ۱۰۰ میلیون ردیف، UUIDv4 بهازای هر ردیف ۱٫۵ تا ۱٫۹ برابر کلید مرجع روی همان server، write-ahead log تولید کرد. گزارش این تفاوت را به تعداد leafهایی مرتبط میداند که در هر چرخه checkpoint لمس و دوباره بهصورت تصویر کامل ثبت میشوند.
Postgres 18 تابع uuidv7() را دارد. گزارش توصیه میکند UUIDv7 داخل Postgres ساخته شود: در آزمایشی با اختلاف ساعت clientها در محدوده مثبت و منفی ۶۰ ثانیه، index فقط ۶۹ درصد پر بود و ۴۵ درصد leafها خارج از ترتیب بودند. همچنین ORDER BY id DESC LIMIT 100 روی UUIDv4، صد مقدار تصادفی با بزرگترین مقدارها را برمیگرداند، نه لزوماً تازهترین ردیفها.