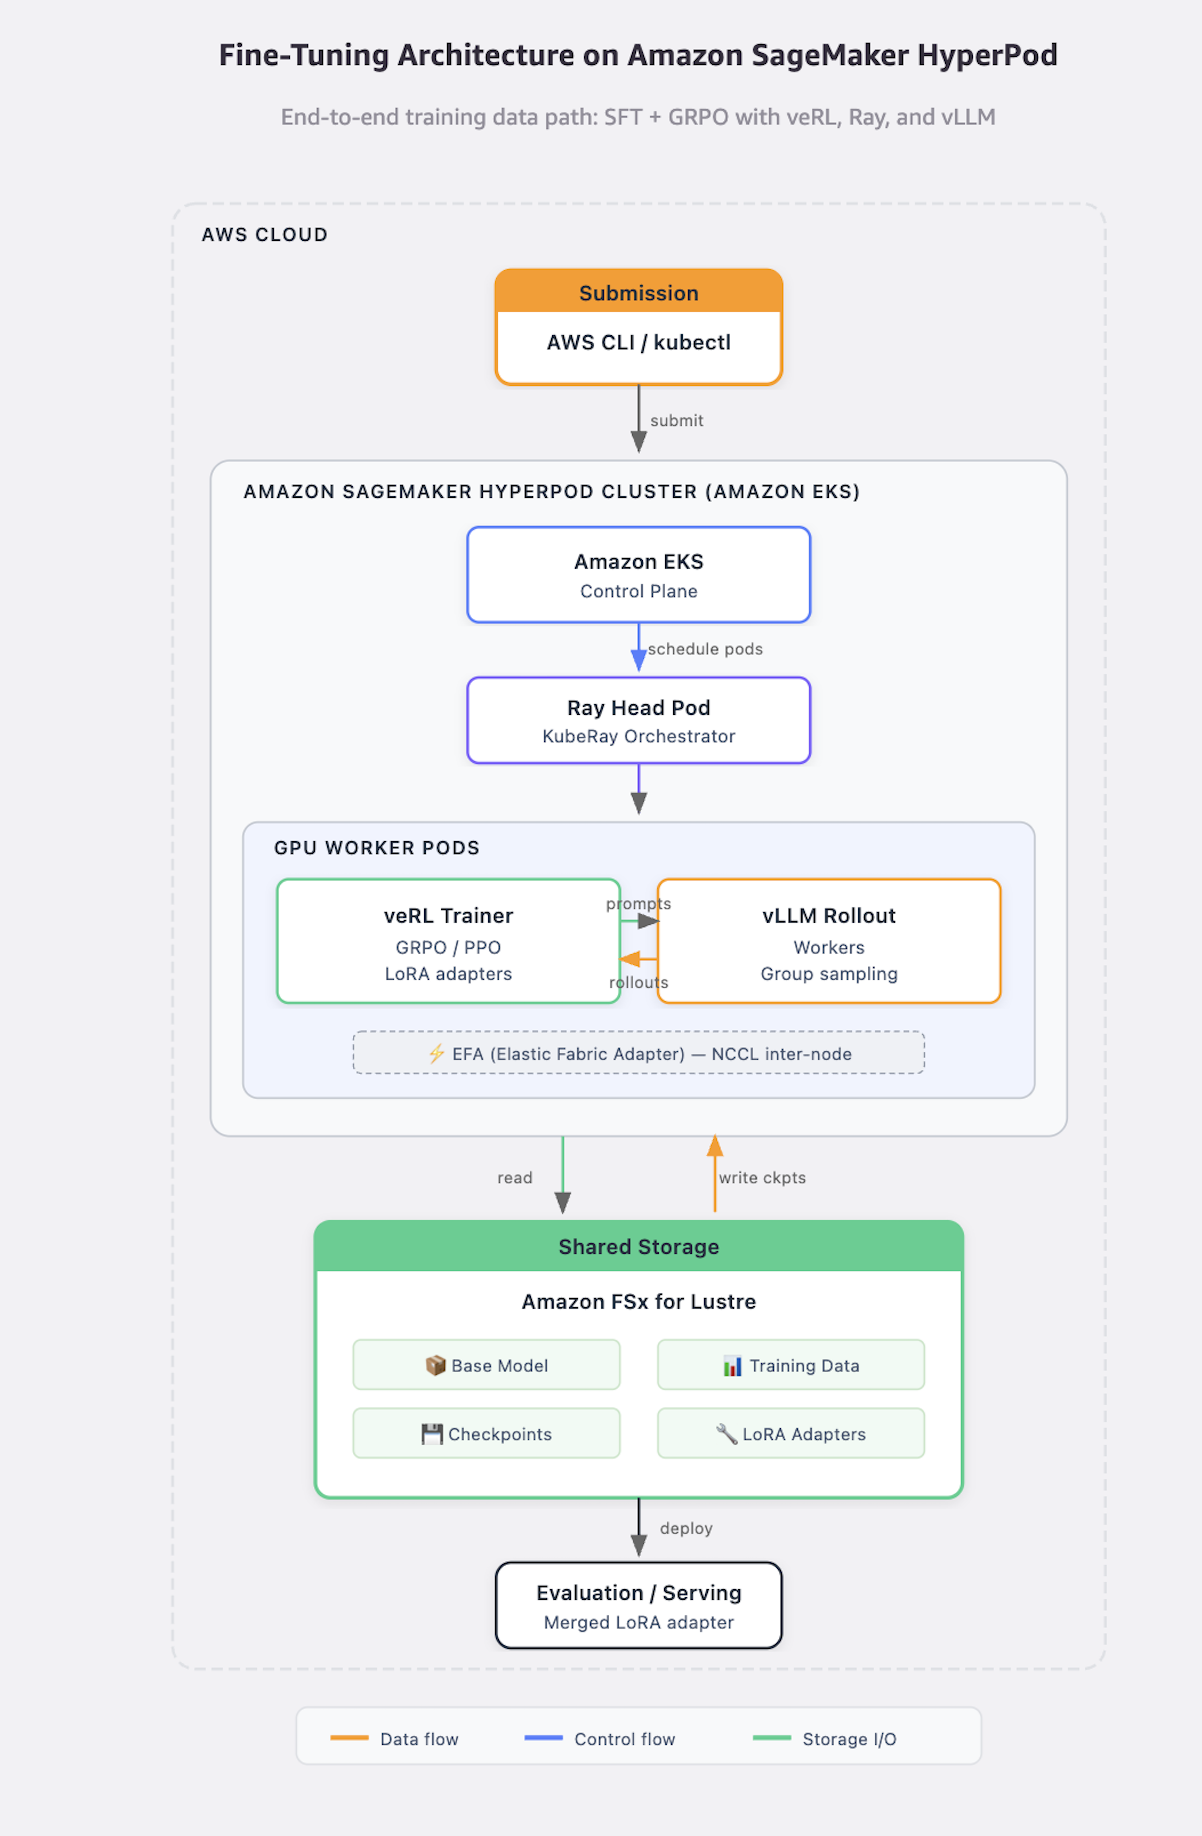
در مقالهای از وبلاگ AWS، فرآیند بهینهسازی مدل GPT-OSS-20B برای استدلال چندزبانه با استفاده از پلتفرم Amazon SageMaker HyperPod توضیح داده شده است. این بهینهسازی شامل استفاده از دو روش اصلی بود: بهینهسازی نظارتشده (SFT) و یادگیری تقویتی با GRPO.
روش SFT توانست دقت مدل در استدلال زبانی را از ۲۲٪ به ۱۰۰٪ افزایش دهد. این نشاندهنده تأثیرگذاری بالای این روش در بهبود عملکرد مدل است. علاوه بر این، استفاده از GRPO در مواردی که هنوز امکان بهبود وجود داشت، بهبودهای قابلتوجهی را به همراه داشت.
این مقاله به توسعهدهندگان کمک میکند تا تصمیم بگیرند که کدام روش بهینهسازی برای نیازهای خاص پروژههایشان مناسبتر است. برای اطلاعات بیشتر و جزئیات فنی میتوانید به منبع اصلی مراجعه کنید.