مقایسه جستجوی برداری در شش موتور database

چرا مهم است

اگر با جستجوی برداری کار می‌کنی، این بررسی بهت کمک می‌کنه تا بفهمی کدوم database برای نیازهای تو بهتره. با مقایسه معیارهای مختلف، می‌تونی انتخاب بهتری داشته باشی و عملکرد بهتری از سیستم‌هات بگیری.

قبل از خواندن، این‌ها را بدان۳ مفهوم
Embedding

یک روش برای نمایش داده‌ها به صورت بردارهای عددی که معمولاً در machine learning و پردازش زبان طبیعی استفاده می‌شود.

بیشتر درباره این مفهوم

embeddings

بردارهای عددی که برای نمایش داده‌ها در فضای چندبعدی استفاده می‌شوند و در کاربردهای مختلفی از جمله جستجوی برداری به کار می‌روند.

بیشتر درباره این مفهوم

HNSW index

یک ساختار داده برای جستجوی برداری که از گراف‌های نزدیک‌ترین همسایه استفاده می‌کند تا جستجوهای سریع و کارآمد را فراهم کند.

بیشتر درباره این مفهوم

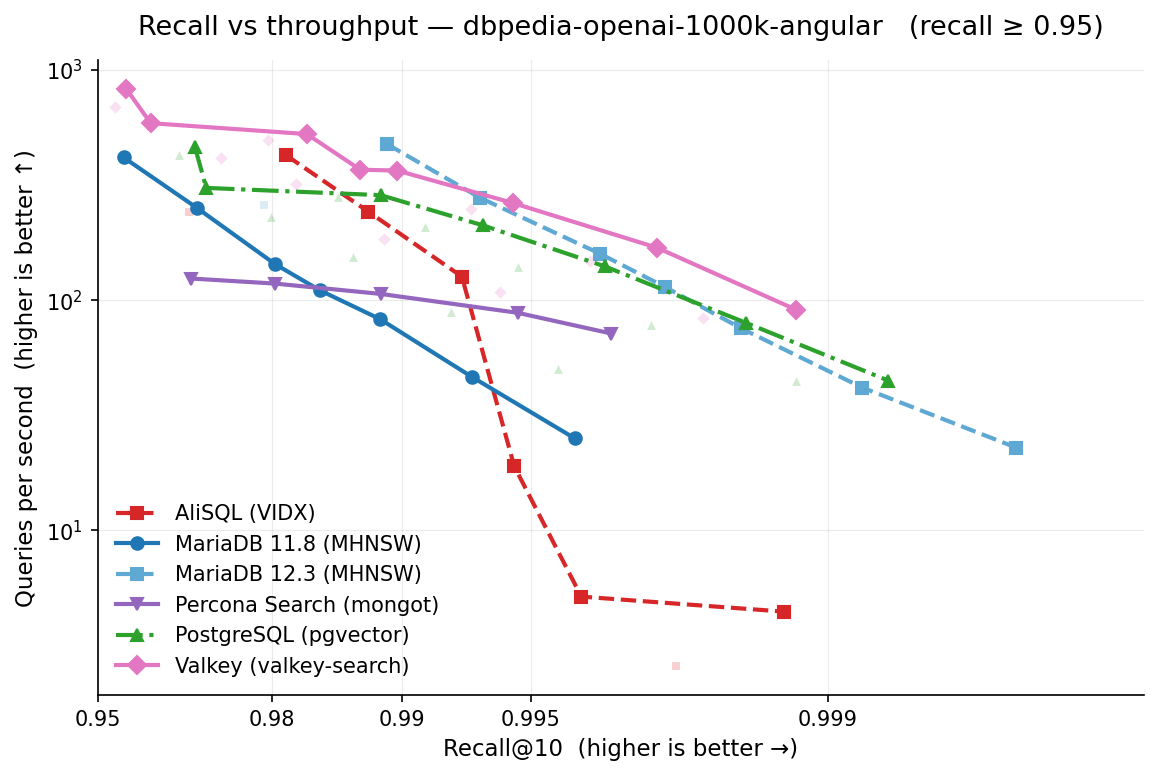
در این مطالعه، ۹۹۰,۰۰۰ بردار OpenAI با ابعاد ۱۵۳۶ در شش database که قابلیت ایندکس‌گذاری بردار‌ها را دارند، بارگذاری شدند. در هر یک از این database‌ها، یک HNSW index ساخته شد و پنج معیار مختلف اندازه‌گیری شد: زمان لازم برای ایجاد یک index قابل جستجو، میزان مصرف حافظه و فضای ذخیره‌سازی، میزان دقت در برابر توان عملیاتی، توان عملیاتی تحت بار concurrency مشتری‌ها و تأثیر بازنویسی ۱۰٪ از داده‌ها.

تمامی این آزمایش‌ها در یک میزبان و با شکل container یکسان انجام شدند تا نتایج به‌دست‌آمده قابل مقایسه باشند. این بررسی به توسعه‌دهندگان کمک می‌کند تا درک بهتری از عملکرد جستجوی برداری در database‌های مختلف داشته باشند و بتوانند بهترین گزینه را برای نیازهای خاص خود انتخاب کنند.
نکته کلیدی

یاد بگیر که چطور معیارهای مختلف مثل زمان ایجاد index و توان عملیاتی می‌تونن روی انتخاب database مناسب تأثیر بذارن. این اطلاعات بهت کمک می‌کنه تا در پروژه‌هات تصمیمات بهتری بگیری و کارایی سیستم‌هات رو بهبود بدی.

خواندن مقاله اصلی (در زبانه‌ی جدید باز می‌شود)
برچسب‌ها (۵)