آموزش Real Python به سراغ ChromaDB رفته است؛ یک vector database از نوع open-source برای برنامههایی که از LLM استفاده میکنند. مسئلهٔ اصلی، انتخاب اطلاعات مرتبط برای مدل است: مدل بهتنهایی فقط اطلاعات موجود در دادههای آموزشیاش را دارد و در هر نوبت نیز تعداد محدودی token میخواند. بنابراین، برای کاری مثل خلاصهکردن اسناد محرمانهٔ شرکت، ابتدا باید مشخص کرد کدام اسناد در اختیار مدل قرار بگیرند.
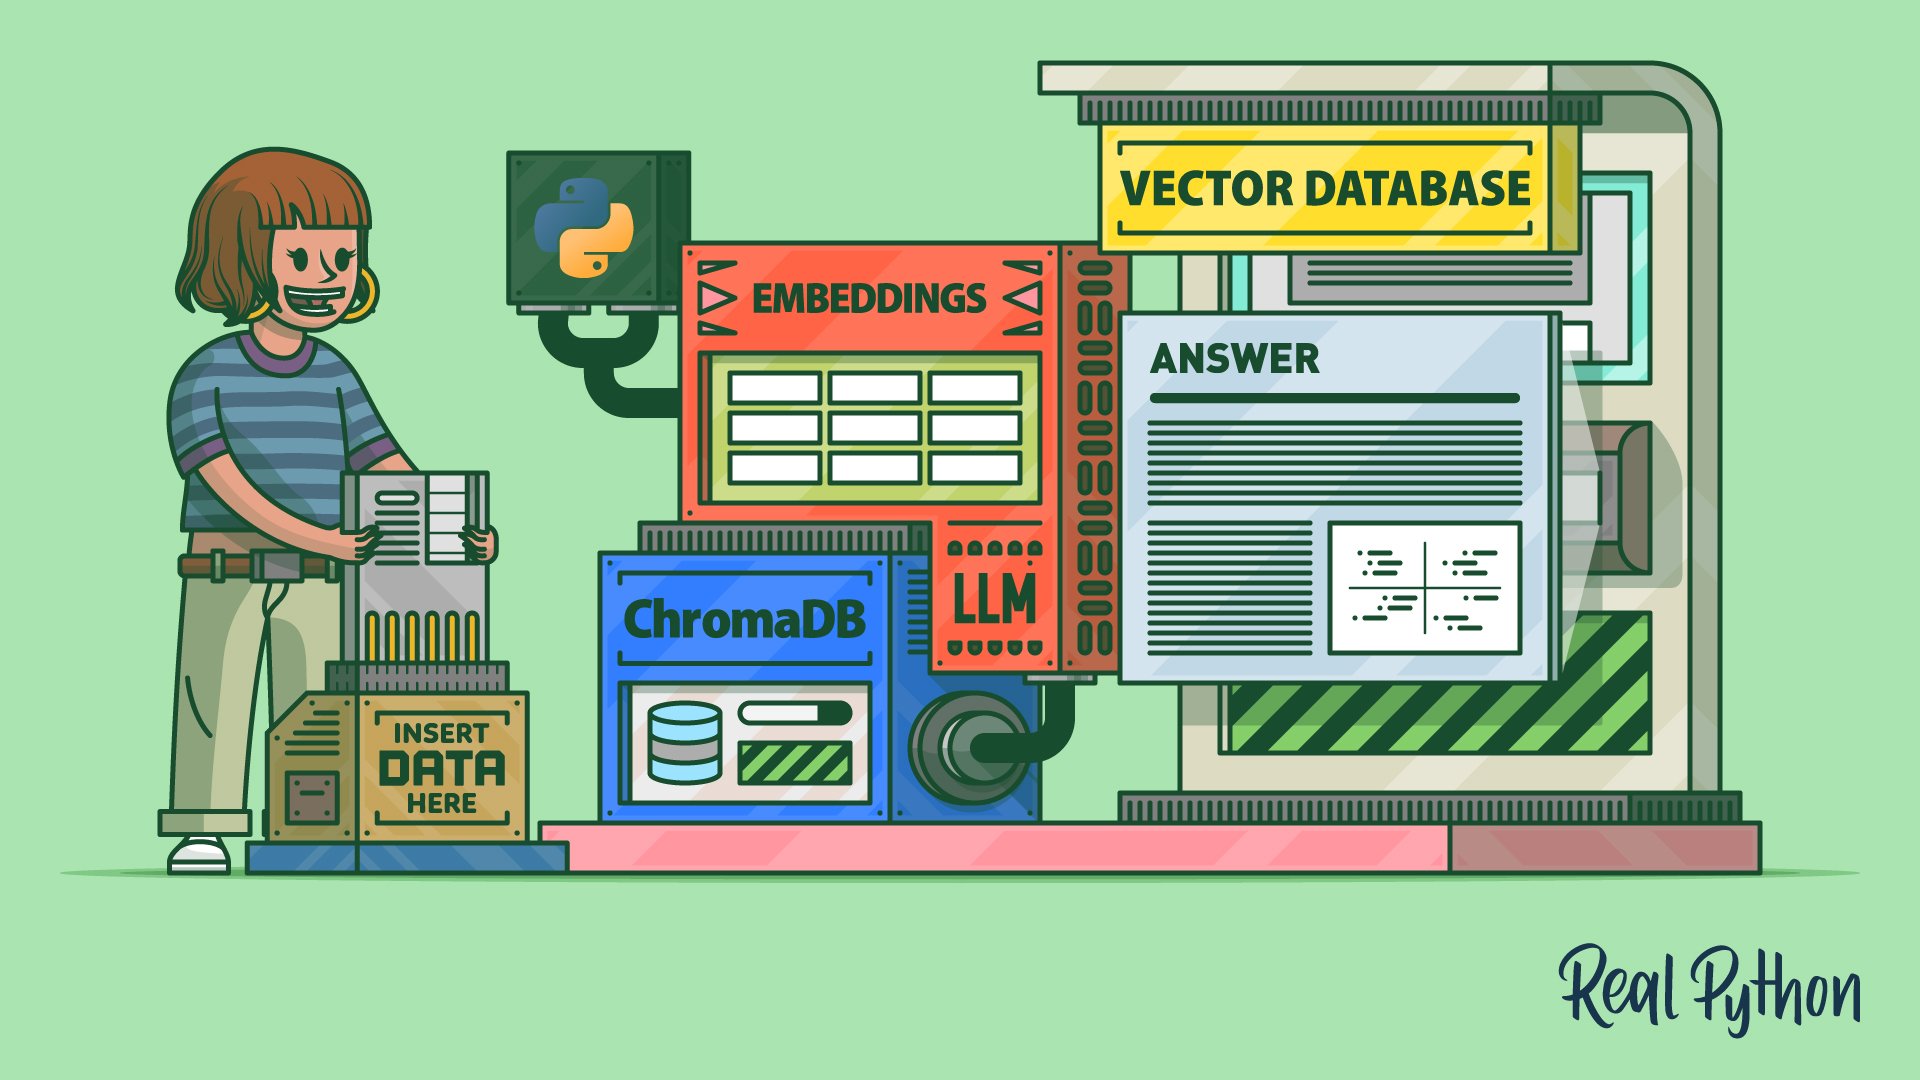
راهکاری که این آموزش معرفی میکند، نمایش متن و دیگر دادههای بدون ساختار بهشکل vector است؛ یعنی آرایههایی از اعداد که میتوان آنها را با هم مقایسه کرد. embeddings نوعی dense vector هستند که معنای واژهها و متن را ثبت میکنند. در معرفی آموزش، spaCy و SentenceTransformers بهعنوان ابزارهای ساخت embeddings در Python نام برده شدهاند. vector database نیز بهجای تکیه بر تطابق دقیق، مواردی را برمیگرداند که بیشترین شباهت را با query دارند.
طبق توضیح مقاله، ChromaDB امکان ساخت collection، افزودن اسناد همراه با metadata و اجرای semantic query با فیلترهای metadata را فراهم میکند. این قابلیت در Retrieval-augmented generation (RAG) کاربرد دارد: اسناد مرتبط از vector database پیدا میشوند و بهعنوان context در اختیار LLM قرار میگیرند. در نتیجه، محور آموزش فقط نگهداری متن نیست، بلکه انتخاب اطلاعات مناسب برای پاسخ به یک پرسش است.
بخش موجود از متن، پیش از رسیدن به این کاربردها، مبانی vector را با NumPy توضیح میدهد. نمونهها ساخت آرایه، بررسی تعداد عناصر، محاسبهٔ norm و dot product را نشان میدهند. برای محاسبهٔ dot product هم روش ضرب عنصربهعنصر و جمع نتایج آمده و هم استفاده از عملگر @ که متن آن را خواناتر معرفی میکند. Cosine Similarity نیز برای سنجش میزان همجهتبودن دو vector معرفی شده است.
این آموزش برای ChromaDB 1.5 و Python 3.12 یا جدیدتر نوشته شده و نسخهٔ packageها در دستورهای نصب مشخص شده است تا با نسخههای آزمایششده یکسان باشند. پیشنیاز آن آشنایی با مبانی Python و ریاضی دبیرستان است. برای جزئیات و نمونههای کامل، به مطلب اصلی در Real Python مراجعه کن.