Columnar Storage
روشی برای ذخیره داده که مقدارهای هر ستون را کنار هم نگه میدارد، نه مقدارهای هر ردیف را.
توضیح
در این روش، دادههای هر ستون جدا از ستونهای دیگر ذخیره میشوند. اگر یک query فقط به چند ستون نیاز داشته باشد، میتوان همان ستونها را خواند و از خواندن بقیه گذشت. کنار هم بودن مقدارهای همنوع معمولاً فشردهسازی را هم مؤثرتر میکند؛ به همین دلیل این چیدمان برای تحلیل حجم زیادی از داده مناسب است.
مثال
فرض کن اطلاعات خریدها شامل نام مشتری، تاریخ و مبلغ است. بهجای نگهداری یک برگه برای هر خرید، نامها، تاریخها و مبلغها در سه فهرست جدا و با ترتیب متناظر قرار دارند. برای جمع زدن مبلغ خریدها، فقط فهرست مبلغها را میخوانی.
چرا مهم است
هنگام ساخت گزارش یا اجرای queryهای تحلیلی با آن روبهرو میشوی. اگر فقط چند ستون از یک جدول بزرگ لازم باشد، این روش میتواند حجم دادهای را که باید خوانده شود کاهش دهد.
مفهومهای مرتبط
این کارت را هوش مصنوعی نوشته و دو بار با هوش مصنوعی بررسی شده است.
مطالبی با این مفهوم
- Benchmarks
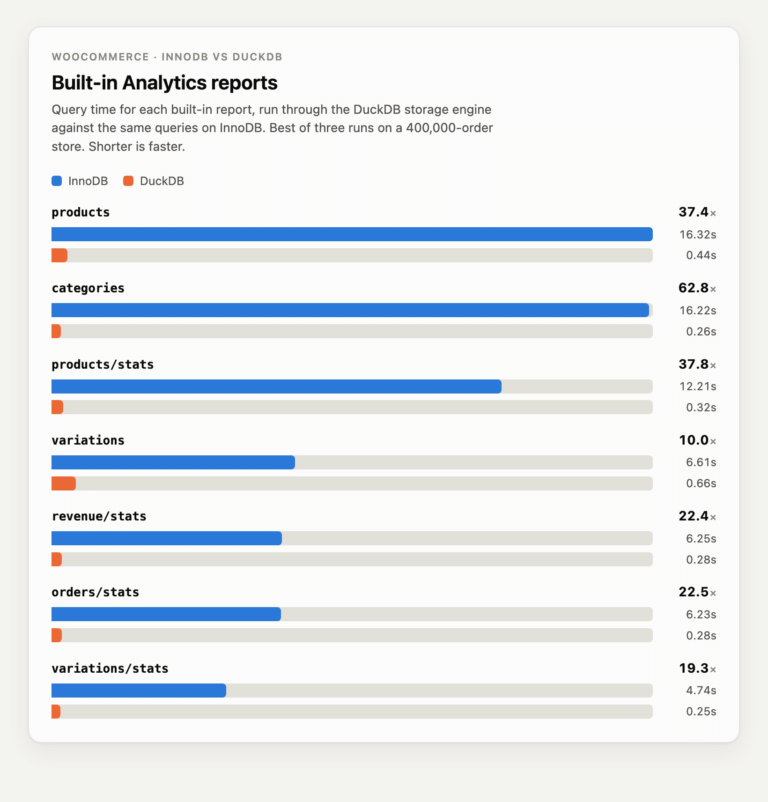
تحلیل دادههای WooCommerce با DuckDB روی Replica در MySQL
Percona برای جداکردن گزارشهای WooCommerce از پردازش سفارشها، یک Replica با DuckDB ساخته است. در آزمایش گزارششده، دادهها با InnoDB به ۷٫۳ GiB و با DuckDB به ۶۰۱ MiB فضا نیاز داشتند.