گزارش Google Cloud از یک پرونده پشتیبانی در ژانویه ۲۰۲۶، با نشانهای آشنا شروع میشود: podها گاهی نمیتوانستند به Kubernetes API server وصل شوند و خطای timeout میگرفتند. این اختلال در محیط چندـcluster یک مشتری در europe-west، حدود ۸۰۰ توسعهدهنده را برای هفتهها از deploy در production بازداشت. به گفته گزارش، پشت این نشانه مشترک سه bug مستقل در سه لایه متفاوت قرار داشت و اصلاح نهایی بهصورت patch در Linux kernel انجام شد.
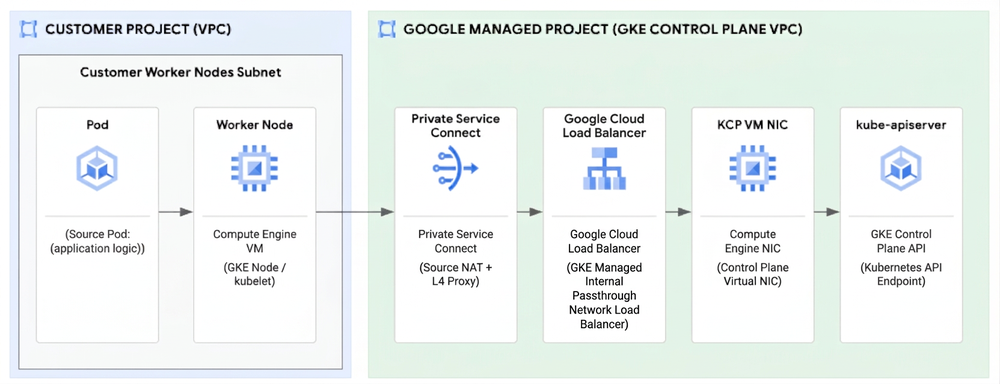
محیط مشتری از Private Service Connect برای دسترسی خصوصی به Control Plane استفاده میکرد. ابزارهایی مانند Twistlock، External Secrets Operator و Cilium، همراه با operatorهای داخلی، در آن فعال بودند. نخستین خطاها در یک cluster آزمایشی دیده شد و چند روز بعد به cluster دوم رسید؛ تا روز دهم، خطاهای پراکنده به مشکلی مداوم تبدیل شده بودند.
تیم بررسی ابتدا سراغ تغییرهای اخیر رفت. یک operator سفارشی ساختهشده با kopf مظنون بود، اما خطاها هشت روز پیش از deployment آن شروع شده بودند و با خاموشکردنش هم ادامه یافتند. حذف External Secrets Operator و agentهای امنیتی نیز نتیجهای نداشت. فرضیه پرشدن Conntrack کنار گذاشته شد، چون جدول تقریباً نصف ظرفیت خود را مصرف میکرد. افزایش اندازه VM مربوط به Control Plane هم timeout را برطرف نکرد.
دامنه اختلال به پنج cluster میرسید و فقط workloadهای مشتری را درگیر نمیکرد؛ podهای سیستمی، لپتاپ توسعهدهندهها و runnerهای GitHub Actions نیز مشکل داشتند. در روز بیستودوم، تیم به Packet Capture همزمان در NIC ماشین Control Plane و داخل container مربوط به kube-apiserver روی آورد.
مسیر ارتباط از Private Service Connect، یک load balancer داخلی و Envoy عبور میکرد. بررسیها نشان داد بسته SYN به NIC مقصد میرسد، اما بهجای SYN-ACK مورد انتظار در TCP Handshake، پاسخ ACK متعلق به یک اتصال قدیمی برمیگردد. Wireshark نیز استفاده دوباره از شماره port را علامت میزد. بخش موجود از گزارش جزئیات سه علت نهایی را ارائه نمیکند؛ اما نشان میدهد چرا با کناررفتن فرضیههای اولیه، بررسی مستقیم بستههای شبکه برای ادامه عیبیابی تعیینکننده شد.